
大家好,又见面了,我是你们的朋友全栈君。
窗口函数 row number + partition by 排序
1 背景
今天实习学到了一个很牛逼的sql函数,而且解决了一个之前面试头条时候的SQL问题!(也知道了为啥头条挂了…毕竟当时SQL做错了)
- 前一篇关于SQL的推文(给链接)最后形成的表是这样的:
import pandas as pd
df = pd.read_excel('./sql数据处理与提取-窗口函数-0327.xlsx', sheet_name='interest0')
df
| deviceid | categoryinterest | interests1 | interests_news | interests_score | |
|---|---|---|---|---|---|
| 0 | 65762973 | 军事:1.0,娱乐:0.917,军事/装备:0.916,娱乐/明星八卦:0.874,历史/古… | 体育/冰雪运动:0.641 | 体育/冰雪运动 | 0.641 |
| 1 | 774830731 | 历史/古代史:1.0,历史:0.5 | 历史/古代史:1.0 | 历史/古代史 | 1.000 |
| 2 | 65762973 | 军事:1.0,娱乐:0.917,军事/装备:0.916,娱乐/明星八卦:0.874,历史/古… | 人文/人文科普:0.584 | 人文/人文科普 | 0.584 |
| 3 | 124901984 | 情感/两性:1.0,历史/古代史:0.933,娱乐:0.901,情感:0.742,体育/乒乓… | 体育/NBA:0.566 | 体育/NBA | 0.566 |
| 4 | 874657455 | 体育/国际足球:9.063,体育/中国足球:3.019,娱乐/综艺:1.947,体育/NBA… | 体育/乒乓球:0.207 | 体育/乒乓球 | 0.207 |
现在的需求是这样:
- 计算每一个deviceid下interests_score前三以及对应的interests_news
- 并且interests_news的前面的标签不能有“娱乐” “要闻” “社会”
- 根据第二步拆开之后,如果后面为空,即没有联合标签,取前面的,非空则取后面的。
2 SQL牛逼函数走起来
2.1 Step1
- Step1:使用pslit函数根据反斜杠将interests_news进行切分为tag_1和tag_2
2.2 SQL实现1
(select
		deviceid,interests_news,split(interests_news,'/')[0] as tag_1,split(interests_news,'/')[1] as tag_2,
		interests_score
		from
		(select
			deviceid,categoryinterest,interests1,
			split(interests1, ':')[0] as interests_news,
			split(interests1, ':')[1] as interests_score
		from
			(select
			deviceid,categoryinterest,interests1
			from
			table1
			lateral view explode(split(categoryinterest,',')) tb1 as interests1
			where
			day=20190313
			group by
			deviceid,categoryinterest,interests1
			)t1
		)t2
		where
		interests_score>=0.5 and interests_score<=1 --获取高分值兴趣点
		group by
		deviceid,interests_news,split(interests_news,'/')[0] ,split(interests_news,'/')[1],interests_score
		-- 疑问 为啥没有直接用tag_1 tag_2
	)interests0
2.3 Step2
Step2:均在select中实现!+ where限制
- 并且舍弃tag_1为“娱乐” “要闻” “社会”三类的 where判断
- 合并tag_1与tag_2 使用case when 如果tag_2非空则取tag_2 否则取tag_1
- 使用row number函数 + partition by + order by 并且取排名前三 where
3.4 SQL实现2
select
	deviceid,
	interests_score,
	tag_type
--	collect_set(tag_type)as interests_array --行转纵
from
	(select
	deviceid,interests_news,interests_score,
	case when tag_2 is not null then tag_2 when tag_2 is null then tag_1 end as tag_type,--二级标签不为空取二级标签值,若二级为空,则取一级标签
	row_number() over(partition by deviceid order by interests_score desc) rank --对单个用户,按照分值降序
	-- 表示根据deviceid分组,在分组内部根据 interests_score 降序,而此函数计算的值就表示每个id内部根据score排序后的顺序编号记为rank(组内连续的唯一的)

	from
	(select
		deviceid,interests_news,split(interests_news,'/')[0] as tag_1,split(interests_news,'/')[1] as tag_2,
		interests_score
		from
		(select
			deviceid,categoryinterest,interests1,
			split(interests1, ':')[0] as interests_news,
			split(interests1, ':')[1] as interests_score
		from
			(select
			deviceid,categoryinterest,interests1
			from
			portal.ddm_user_multiprod_user_portrait_d
			lateral view explode(split(categoryinterest,',')) tb1 as interests1
			where
			day=20190313
			group by
			deviceid,categoryinterest,interests1
			)t1
		)t2
		where
		interests_score>=0.5 and interests_score<=1 --获取高分值兴趣点
		group by
		deviceid,interests_news,split(interests_news,'/')[0] ,split(interests_news,'/')[1],interests_score
		-- 疑问 为啥没有直接用tag_1 tag_2
	)interests0
	where
	tag_1 not in ('娱乐','社会','要闻','未知') --去除主流兴趣标签影响
	)interests00
	where
	rank<=4 --获取几类二级标签的组合 取top4
group by
	deviceid,
	interests_score,
	tag_type
- 结果为:
df = pd.read_excel('./sql数据处理与提取-窗口函数-0327.xlsx', sheet_name='step3')
df
| deviceid | interests_news | tag_type | interests_score | rank | |
|---|---|---|---|---|---|
| 0 | 65762973 | 体育/冰雪运动 | 冰雪运动 | 0.641 | 1 |
| 1 | 65762973 | 人文/人文科普 | 人文科普 | 0.584 | 2 |
| 2 | 774830731 | 历史/古代史 | 古代史 | 1.000 | 1 |
| 3 | 124901984 | 体育/NBA | NBA | 0.566 | 1 |
| 4 | 874657455 | 体育/乒乓球 | 乒乓球 | 0.207 | 1 |
总结:
-
row number()函数特别好用 往往配合 partition by 以及 order by
参考:https://www.cnblogs.com/icebutterfly/archive/2009/08/05/1539657.html -
上述函数适用情况:当需要根据某一个标签进行分组并且在组内需要根据另一个字段进行降序or升序排列 打上排名 视情况取前几名 【下面还会举一个头条面试的例子】
-
case when函数语句:使用在select语句中,并且是
case when *** then *** when *** then *** (else *** ) end as 新字段名称
2.5 补充-collect函数
作用:用来多行转为一行的方法 它返回一个消除了重复元素的对象集合, 其返回值类型是 array 。
SQL语句:
select deviceid, collect_set(tag_type) as interests_array
from 上述表
- 结果为:
| deviceid | interests_array | |
|---|---|---|
| 0 | 65762973 | [“冰雪运动”, “人文科普”] |
| 1 | 774830731 | [“古代史”] |
| 2 | 124901984 | [“NBA”] |
| 3 | 874657455 | [“乒乓球”] |
3 头条面试SQL题
3.1 题目
前段时间找实习去头条面试,最后被虐的体无完肤…其中面试官灵魂拷问:你SQL咋样?如果1-10分,你给自己的SQL打几分?我当时内心就无语了!?还有这种操作?嗨呀,SQL当时完全自学,当时没有实习,没有任何场景应用,所以水平明显很次,内心TMD脸上笑嘻嘻的说:6分,及格吧。面试官同样皮笑肉不笑的说,好,那我出个题哈,(面试官内心os:小样,那我就出个6分水平的题,看你答不答得出来!)
题目是这样的:
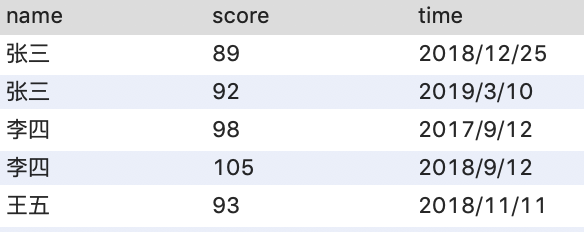
现在有一张表,有三列,一列是学生的姓名,一列是学生的雅思考试成绩,一列是考试时间,学生可以多次参加雅思考试,现在想要统计出不同学生最近一次考试时间的成绩!你说说思路吧!
3.2 实现
嗨呀,当时稍微想了一下,感觉不难嘛,于是脱口而出:
select name, score, max(time) from table group by name
当时信心满满,但是回来和同学一聊,有说对的有说错的,尴尬!直到今天在公司遇到一个和这个很类似的问题啊!于是请教了我的leader,并且当场给我建了个临时表show了一把,结果是我错了,这种方法是不对的!
正确答案现在来看,肯定不难了:
- 首先取出三列,然后使用row number函数 根据姓名进行partition by 然后对时间进行降序排列 取rank小于等于1的即可
select *,
Row_Number() over (partition by name order by time desc) rank
from IELTS
where rank <= 1
那当时的做法对不对呢?废话不多话,建一个表试试!
3.2 建表

结果为:
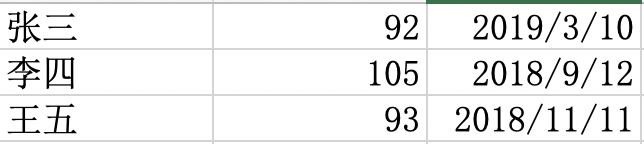
注:这次的代码刚在本机竟然没有跑通,后天去公司再请教下leader…不过逻辑肯定是没问题的~
未完待续
0716更新:后续请参考博客:SQL | 关于窗口函数的补充
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/139467.html原文链接:https://javaforall.net



