
大家好,又见面了,我是你们的朋友全栈君。
RAID0
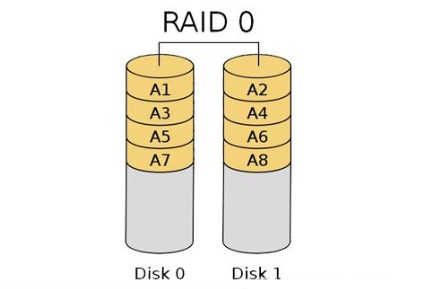

定义:
RAID 0又称为Stripe或Striping,它代表了所有RAID级别中最高的存储性能。RAID 0提高存储性能的原理是把连续的数据分散到多个磁盘上存取,这样,系统有数据请求就可以被多个磁盘并行的执行,每个磁盘执行属于它自己的那部分数据请求。这种数据上的并行操作可以充分利用总线的带宽,显著提高磁盘整体存取性能。
工作原理:
系统向三个磁盘组成的逻辑硬盘(RAID0 磁盘组)发出的I/O数据请求被转化为3项操作,其中的每一项操作都对应于一块物理硬盘。通过建立RAID 0,原先顺序的数据请求被分散到所有的三块硬盘中同时执行。从理论上讲,三块硬盘的并行操作使同一时间内磁盘读写速度提升了3倍。 但由于总线带宽等多种因素的影响,实际的提升速率肯定会低于理论值,但是,大量数据并行传输与串行传输比较,提速效果显著显然毋庸置疑。
优缺点:
读写性能是所有RAID级别中最高的。
RAID 0的缺点是不提供数据冗余,因此一旦用户数据损坏,损坏的数据将无法得到恢复。RAID0运行时只要其中任一块硬盘出现问题就会导致整个数据的故障。一般不建议企业用户单独使用。
总结:
磁盘空间使用率:100%,故成本最低。
读性能:N*单块磁盘的读性能
写性能:N*单块磁盘的写性能
冗余:无,任何一块磁盘损坏都将导致数据不可用。
RAID1
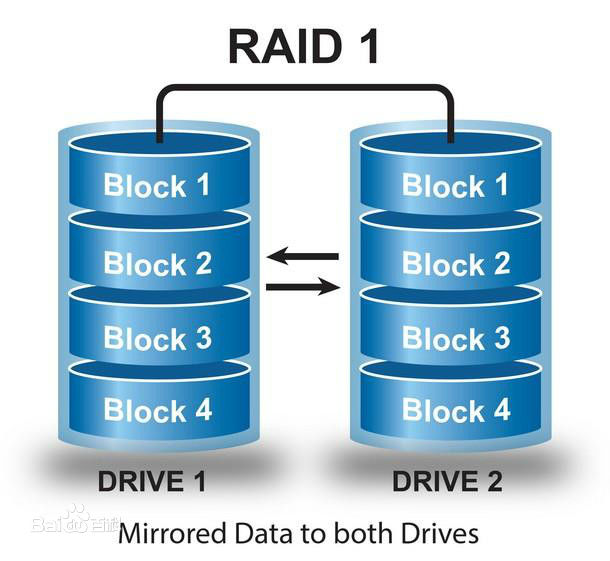
定义:
RAID 1通过磁盘数据镜像实现数据冗余,在成对的独立磁盘上产生互为备份的数据。当原始数据繁忙时,可直接从镜像拷贝中读取数据,因此RAID 1可以提高读取性能。RAID 1是磁盘阵列中单位成本最高的,但提供了很高的数据安全性和可用性。当一个磁盘失效时,系统可以自动切换到镜像磁盘上读写,而不需要重组失效的数据。
工作原理:
RAID1是将一个两块硬盘所构成RAID磁盘阵列,其容量仅等于一块硬盘的容量,因为另一块只是当作数据“镜像”。RAID1磁盘阵列显然是最可靠的一种阵列,因为它总是保持一份完整的数据备份。它的性能自然没有RAID0磁盘阵列那样好,但其数据读取确实较单一硬盘来的快,因为数据会从两块硬盘中较快的一块中读出。RAID1磁盘阵列的写入速度通常较慢,因为数据得分别写入两块硬盘中并做比较。RAID1磁盘阵列一般支持“热交换”,就是说阵列中硬盘的移除或替换可以在系统运行时进行,无须中断退出系统。RAID1磁盘阵列是十分安全的,不过也是较贵一种RAID磁盘阵列解决方案,因为两块硬盘仅能提供一块硬盘的容量。RAID1磁盘阵列主要用在数据安全性很高,而且要求能够快速恢复被破坏的数据的场合。
在这里,需要注意的是,读只能在一块磁盘上进行,并不会进行并行读取,性能取决于硬盘中较快的一块。写的话通常比单块磁盘要慢,虽然是并行写,即对两块磁盘的写入是同时进行的,但因为要比较两块硬盘中的数据,所以性能比单块磁盘慢。
优缺点:
RAID1通过硬盘数据镜像实现数据的冗余,保护数据安全,在两块盘上产生互为备份的数据,当原始数据繁忙时,可直接从镜像备份中读取数据,因此RAID1可以提供读取性能。
RAID1是硬盘中单位成本最高的,但提供了很高的数据安全性和可用性,当一个硬盘失效时,系统可以自动切换到镜像硬盘上读/写,并且不需要重组失效的数据。
总结:
磁盘空间使用率:50%,故成本最高。
读性能:只能在一个磁盘上读取,取决于磁盘中较快的那块盘
写性能:两块磁盘都要写入,虽然是并行写入,但因为要比对,故性能单块磁盘慢。
冗余:只要系统中任何一对镜像盘中有一块磁盘可以使用,甚至可以在一半数量的硬盘出现问题时系统都可以正常运行。
RAID 5
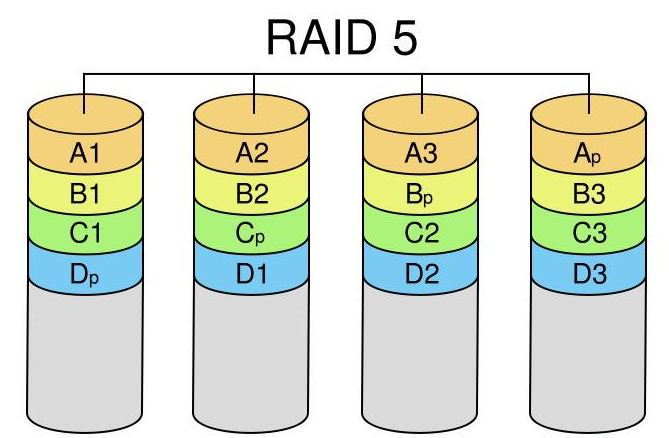
定义:
RAID 5是RAID 0和RAID 1的折中方案。RAID 5具有和RAID0相近似的数据读取速度,只是多了一个奇偶校验信息,写入数据的速度比对单个磁盘进行写入操作稍慢。同时由于多个数据对应一个奇偶校验信息,RAID5的磁盘空间利用率要比RAID 1高,存储成本相对较低,是目前运用较多的一种解决方案。
工作原理:
RAID5把数据和相对应的奇偶校验信息存储到组成RAID5的各个磁盘上,并且奇偶校验信息和相对应的数据分别存储于不同的磁盘上,其中任意N-1块磁盘上都存储完整的数据,也就是说有相当于一块磁盘容量的空间用于存储奇偶校验信息。因此当RAID5的一个磁盘发生损坏后,不会影响数据的完整性,从而保证了数据安全。当损坏的磁盘被替换后,RAID还会自动利用剩下奇偶校验信息去重建此磁盘上的数据,来保持RAID5的高可靠性。
做raid 5阵列所有磁盘容量必须一样大,当容量不同时,会以最小的容量为准。 最好硬盘转速一样,否则会影响性能,而且可用空间=磁盘数n-1,Raid 5 没有独立的奇偶校验盘,所有校验信息分散放在所有磁盘上, 只占用一个磁盘的容量。
总结:
磁盘空间利用率:(N-1)/N,即只浪费一块磁盘用于奇偶校验。
读性能:(n-1)*单块磁盘的读性能,接近RAID0的读性能。
写性能:比单块磁盘的写性能要差(这点不是很明白,不是可以并行写入么?)
冗余:只允许一块磁盘损坏。
RAID10
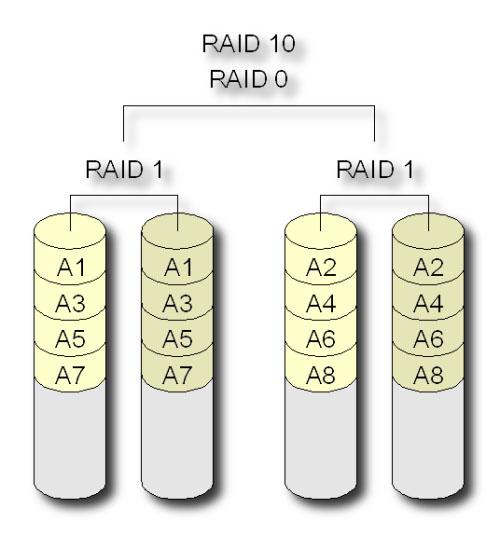
定义:
RAID10也被称为镜象阵列条带。象RAID0一样,数据跨磁盘抽取;象RAID1一样,每个磁盘都有一个镜象磁盘, 所以RAID 10的另一种会说法是 RAID 0+1。RAID10提供100%的数据冗余,支持更大的卷尺寸,但价格也相对较高。对大多数只要求具有冗余度而不必考虑价格的应用来说,RAID10提供最好的性能。使用RAID10,可以获得更好的可靠性,因为即使两个物理驱动器发生故障(每个阵列中一个),数据仍然可以得到保护。RAID10需要4 + 2*N 个磁盘驱动器(N >=0), 而且只能使用其中一半(或更小, 如果磁盘大小不一)的磁盘用量, 例如 4 个 250G 的硬盘使用RAID10 阵列, 实际容量是 500G。
实现原理:
Raid10其实结构非常简单,首先创建2个独立的Raid1,然后将这两个独立的Raid1组成一个Raid0,当往这个逻辑Raid中写数据时,数据被有序的写入两个Raid1中。磁盘1和磁盘2组成一个Raid1,磁盘3和磁盘4又组成另外一个Raid1;这两个Raid1组成了一个新的Raid0。如写在硬盘1上的数据1、3、5、7,写在硬盘2中则为数据1、3、5、7,硬盘中的数据为0、2、4、6,硬盘4中的数据则为0、2、4、6,因此数据在这四个硬盘上组合成Raid10,且具有raid0和raid1两者的特性。
虽然Raid10方案造成了50%的磁盘浪费,但是它提供了200%的速度和单磁盘损坏的数据安全性,并且当同时损坏的磁盘不在同一Raid1中,就能保证数据安全性。假如磁盘中的某一块盘坏了,整个逻辑磁盘仍能正常工作的。
当我们需要恢复RAID10中损坏的磁盘时,只需要更换新的硬盘,按照RAID10的工作原理来进行数据恢复,恢复数据过程中系统仍能正常工作。原先的数据会同步恢复到更换的硬盘中。
总结:
磁盘空间利用率:50%。
读性能:N/2*单块硬盘的读性能
写性能:N/2*单块硬盘的写性能
冗余:只要一对镜像盘中有一块磁盘可以使用就没问题。
发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/154603.html原文链接:https://javaforall.net



