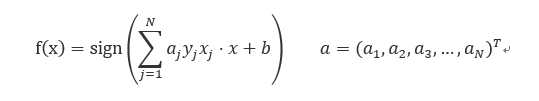感知机的对偶形式「建议收藏」

感知机的对偶形式「建议收藏」首先声明感知机的对偶形式与原始形式并没有多大的区别,运算的过程都是一样的,但通过对偶形式会事先计算好一些步骤的结果并存储到Gray矩阵中,因此可以加快一些运算速度,数据越多节省的计算次数就越多,因此比原始形式更加的优化。首先我们介绍一下感知机的原始形式,之后与其对比。感知机感知机是二类分类的线性分类模型,输入为实例的特征向量,输出为实例的类别,分别去+1和-1两值。感知机对应与输入空间中将实例划

大家好,又见面了,我是你们的朋友全栈君。如果您正在找激活码,请点击查看最新教程,关注关注公众号 “全栈程序员社区” 获取激活教程,可能之前旧版本教程已经失效.最新Idea2022.1教程亲测有效,一键激活。

Jetbrains全系列IDE稳定放心使用

首先声明感知机的对偶形式与原始形式并没有多大的区别,运算的过程都是一样的,但通过对偶形式会事先计算好一些步骤的结果并存储到Gray矩阵中,因此可以加快一些运算速度,数据越多节省的计算次数就越多,因此比原始形式更加的优化。
首先我们介绍一下感知机的原始形式,之后与其对比。

感知机

感知机是二类分类的线性分类模型,输入为实例的特征向量,输出为实例的类别,分别去+1和-1两值。感知机对应与输入空间中将实例划分为正负两类的分离超平面,属于判别模型。感知机学习旨在求出能将训练数据划分的分离超平面,其学习算法为,基于误分类的损失函数利用随机梯度下降法对损失函数进行极小化求解出超平面。

感知机学习算法是对以下问题优化,给定一个训练数据集
T={(x1,y1),(x2,y2),(x3,y3),…,(xN)(yN)}
其中,xi∈X=R^N , yi∈Y={-1,1},i=1,2,…,N,求参数w,b,使其为以下损失函数极小化问题的解。
这里写图片描述
其中M为误分类点的集合。
感知机学习算法,具体采用随机梯度下降法(与梯度下降法每次迭代的是全局所有点不同,随机梯度下降每次只取一个点,虽然每次下降的方向不一定准确,但经过多次迭代,一定会接近最优值)
损失函数L(w,b)的梯度由
这里写图片描述
给出,其中M是固定的误分类点的集合。
随机选取一个误分类点(xi,yi),对w,b进行更新:
这里写图片描述
其中η(0<η<=1)是步长,统计学习中称为学习率,通过这样不断的迭代期待损失函数L(w,b)不断减小,直到为0.

总结下其基本原始算法步骤如下:

输入:训练数据集
这里写图片描述
其中
这里写图片描述
输出:w,b ; 感知机模型 f(x)=sign(w·x+b).
(1) 选取初值 w0 , b0
(2) 在训练集中选取数据(xi,yi)
(3) 如果 yi(w·xi+b)<=0
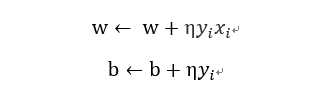
这里写图片描述
(4) 转至步骤(2),直至训练集没有误分类点.
例1(原始形式方式):
如图1训练数据集,其正实例点是 x1=(3,3)^T, x2=(4,3)^T ,负实例点是x3=(1,1)^T,求感知机模型f(x)=sign(w · x + b). 这里w=( w(1),w(2) )^T,x=( x(1),x(2) )^T
这里写图片描述(图1)
解 构造最优化问题:
这里写图片描述
求解w , b . η=1.
这里写图片描述
这里写图片描述

感知机对偶形式

对偶形式的基本想法是,将w和b表示为实例xi和标记yi的线性组合的形式,通过求解其系数而求得w和b
假设w,b初值都为0。
在原始形式中w和b通过每次对一个点的梯度下降,逐步修改w,b
这里写图片描述

设修改n次,那么w,b关于(xi,yi)的增量分别为ni *η *yi *xi和
ni η *yi 。在学习过程中,最后学到的w,b与每个点及其个数有关。
将ai=ni*η.
这里写图片描述

这里ni表示第i个实例点更新的次数,η为步长为1,当η=1时,表示第i个实例点由于误分而进行更新的次数。实例点更新次数越多,意味着它距离分离超平面越近,也就越难正确分类。

从这里可以看出感知机之所以有两种形式,是因为采用的随机梯度下降,随机梯度下降每次迭代的是一个点,而不是整体,因此对于迭代的点有次数的概念。

感知机对偶算法

输入:训练数据集
这里写图片描述
其中
这里写图片描述
输出:a ,b ;
感知机模型
这里写图片描述
ai =ni *η 是次数
(1) a<-0 ,b<-0
(2) 在训练集中选取数据(xi , yi)
(3) 如果
这里写图片描述
(注aj是次数*步长,yj是输出空间结果取值为{-1,1},xj是某点j的向量形式)
(4) 转至(2)指导没有误分类数据。
对偶形式中训练实例仅以内积的形式出现即(3)中的xj · x,为了方便,预先求出内积,并以矩阵形式存储,该矩阵名为Gram矩阵
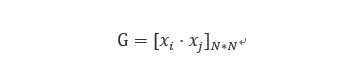
这里写图片描述

这次我们用例1的数据,通过对偶形式求解例一

这里写图片描述
这里写图片描述
这里写图片描述
迭代过程如下
这里写图片描述
由此可以看出对偶算法与原始算法并无太大区别,运算过程一样,
毕竟原始形式中w就是aixiyi的累加和。

版权声明:本文内容由互联网用户自发贡献,该文观点仅代表作者本人。本站仅提供信息存储空间服务,不拥有所有权,不承担相关法律责任。如发现本站有涉嫌侵权/违法违规的内容, 请发送邮件至 举报,一经查实,本站将立刻删除。

发布者:全栈程序员-站长,转载请注明出处:https://javaforall.net/180035.html原文链接:https://javaforall.net

赞 (0)
全栈程序员-站长的头像全栈程序员-站长


相关推荐

  • 在ubuntu系统下安装python

    在ubuntu系统下安装python

    2021年10月6日
  • SpringSecurity权限管理系统实战—一、项目简介和开发环境准备

    SpringSecurity权限管理系统实战—一、项目简介和开发环境准备SpringSecurity实战一—项目简介和开发环境准备一、简介​ 在企业应用中,认证和授权是非常重要的一部分内容,业界最出名的两个框架就是大名鼎鼎的Shiro和SpringSecurity。本次我选取的是和SpringBoot更好兼容的SpringSecurity。

    2022年11月3日
  • AttributeSet 的意义

    AttributeSet 的意义[color=brown]/***ReturnanAttributeSetinterfaceforusewiththegivenXmlPullParser.*IfthegivenparseritselfimplementsAttributeSet,thatimplementation*issimplyre…

    2022年10月30日
  • FEC算法_粒子群算法

    FEC算法_粒子群算法基于IP的语音和视频通话业务为了实时性,一般都是采用UDP进行传输,基站无线一般配置UM模式的RLC承载,因此丢包是不可避免的,在小区信号的边沿则丢包率会更高;为了通话的实时性,一般不会采用接收端发现丢包了然后通知发送端重传的机制,因为这个在应用层的丢包检测和通知发送端重传是非常耗时的。引入前向纠错(FEC)机制是解决实时通话业务丢包的一个很好的机制,FEC的原理就是在发送端发送数据包时插入冗余包…

    2022年8月11日
  • ViewStub基本用法「建议收藏」

    ViewStub基本用法「建议收藏」在开发应用程序的时候,经常会遇到这样的情况,会在运行时动态根据条件来决定显示哪个View或某个布局。那么最通常的想法就是把可能用到的View都写在上面,先把它们的可见性都设为View.GONE,然后在代码中动态的更改它的可见性。这样的做法的优点是逻辑简单而且控制起来比较灵活。但是它的缺点就是,耗费资源。虽然把View的初始可见View.GONE但是在Inflate布局的时候View仍然会被Infl…

    2022年6月28日
  • usb眼图测试方法_USB4.0

    usb眼图测试方法_USB4.01、现象HUB芯片电源噪声所引起;USBHUB芯片电压偏置电阻不合适所引起。2、参考电路3、原因分析在眼图测试时发现有一个USB口的眼图有抖动碰到眼图模板,当时经过千辛万苦,屡试不成,都未找到具体原因。只能确定眼图的抖动可能由于电源的噪声所引起,后续多次更换电源的滤波参数和割PCB后才找到由于一路电源1.8VPLL的布局所引起。真是众里寻她千百度,暮然回首,尽在一个HUBcore电源的滤波未做好。未通过模板时眼图如下图(未做任何调试):未通过模板时所对应的PCB布局..

    2022年10月30日

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

关注全栈程序员社区公众号